Anomalieerkennung
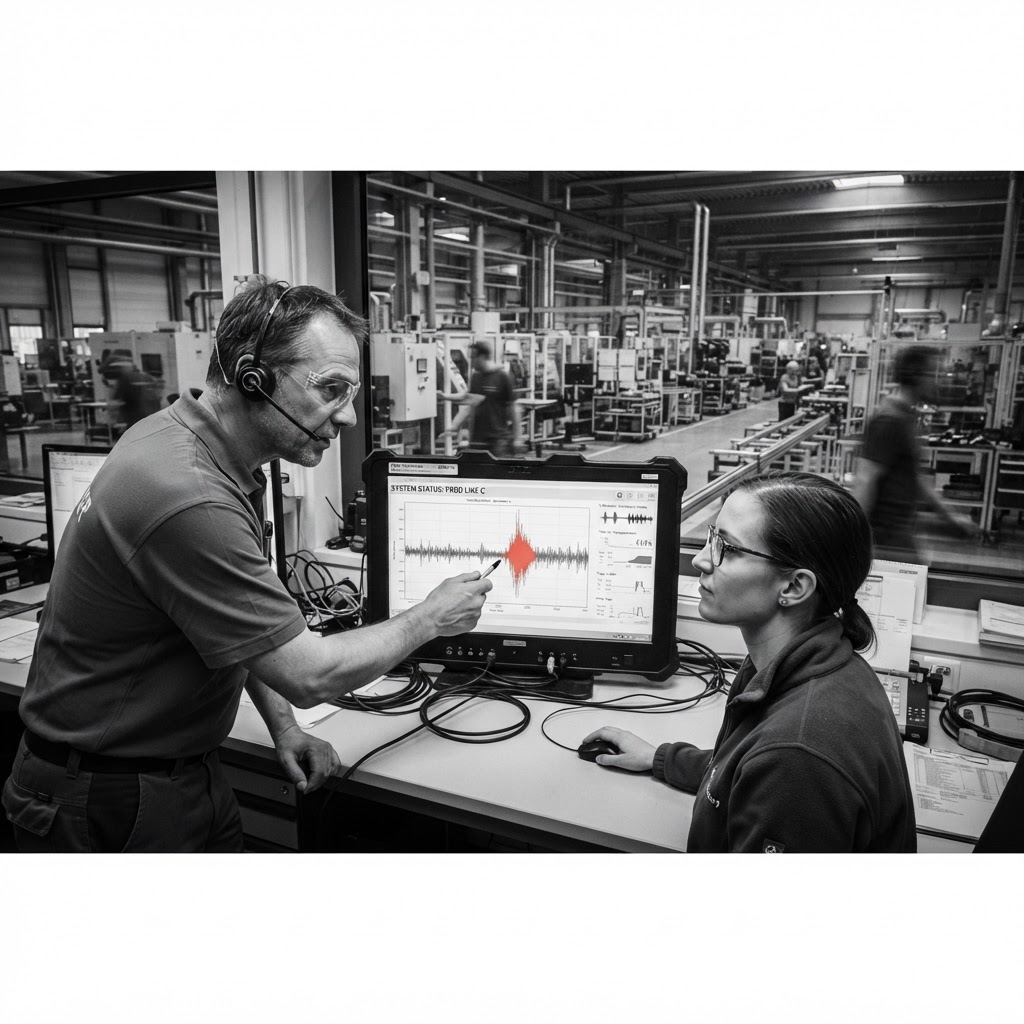
Anomalieerkennung
Kurz erklärt
Die Anomalieerkennung ist ein systematischer Prozess zur Identifikation von Datenmustern, die signifikant von einem definierten Normalzustand abweichen. Sie dient der frühzeitigen Detektion von Auffälligkeiten in technischen Systemen, Produktionsprozessen oder Energienetzen, um proaktiv auf instabile Zustände zu reagieren. Durch den Vergleich aktueller Ist-Daten mit einem erlernten Referenzmodell ermöglicht sie Predictive Maintenance und trägt zur Reduktion ungeplanter Stillstandszeiten bei.
Definition
Anomalieerkennung bezeichnet die rechnergestützte Identifikation von Ausreißern in Datensätzen, die nicht dem erwarteten Verhalten eines Systems entsprechen. In einem fachlich sauberen Kontext definiert sie Zustände, die außerhalb validierter Toleranzbereiche oder der erlernten Prozessnormalität liegen. Ihr Zweck besteht nicht in der direkten Fehlerklassifikation, sondern in der Warnung vor einem abweichenden Systemzustand, der als Vorstufe eines potenziellen Fehlers interpretiert werden kann. Moderne Ansätze nutzen hierfür häufig Machine-Learning-Verfahren wie Autoencoder, die Merkmale des Normalzustands aus fehlerfreien Beispielen erlernen, um Abweichungen in komplexen Zeitreihendaten zu identifizieren.
Bedeutung im Fachkontext
Im Qualitätsmanagement und der Prozessüberwachung dient die Anomalieerkennung der Stabilisierung von Wertschöpfungsketten. Sie fungiert als Detektionsschicht, die Eingangsdaten aus Sensoren, Prozesssteuerungen oder Energiedaten verarbeitet. Das Ergebnis der Analyse ist ein Hinweis, der als Eingabe für eine tiefergehende Ursachenanalyse dient. Sie ist ein Werkzeug zur Reduktion von Prozessrauschen und zur Erhöhung der Resilienz gegenüber schwankenden Prozessbedingungen.
Input, Verarbeitung, Output, Outcome, Impact
Wirkungspfade und Beiträge zu Unternehmenszielen im Detail
Outcome
1. Systematische Verfolgung und Beherrschung aufkommender Risiken durch frühzeitige Intervention; 2. Aufbau einer strukturierten Wissensbasis über Prozessanomalien zur Optimierung von Betriebsparametern in Folgeprojekten.
Impact
Signifikante Reduktion von Qualitätskosten und ungeplanten Stillstandszeiten, Erhöhung der Anlageneffizienz (OEE) sowie verbesserte Lernfähigkeit der Organisation durch datengestützte Fehlerprävention.
Schritte der Methode in Übersicht
Die methodische Umsetzung gliedert sich in fünf logische Phasen, die einen geschlossenen Regelkreis bilden: 1. Definition des Normalzustands; 2. Datenvorbereitung; 3. Modellimplementierung; 4. Kontinuierliches Monitoring; 5. Eskalation und Analyse. Diese Schritte stellen sicher, dass die Erkennungslogik stets auf einem aktuellen und validen Prozessverständnis beruht.
Definition des Normalzustands
Festlegung der Referenzbasis
Datenvorbereitung
Sicherstellung der Signalgüte
Modellimplementierung
Abbildung des Normalverhaltens
Kontinuierliches Monitoring
Echtzeit-Detektion
Eskalation und Analyse
Ursachenklärung
Beschreibung der Einzelschritte mit Ziel & Vorgehen
QUALITY LXP · SCHRITTLOGIK
Definition des Normalzustands
Historische Sensordaten und Prozessprotokolle.
Auswahl und Validierung von Datensätzen, die einen stabilen Prozessbetrieb repräsentieren.
Validierter Datensatz zur Modellierung der Normalität.
5.000 Stunden störungsfreier Betrieb einer Windkraftanlage.
Repräsentativität und Stabilität der gewählten Zeitfenster.
QUALITY LXP · SCHRITTLOGIK
Datenvorbereitung
Rohdaten aus Sensoren oder Leitsystemen.
Bereinigung, Normalisierung und Dimensionsreduktion der Rohdaten.
Bereinigter, vergleichbarer Datensatz.
Entfernung von Rauschen aus Smart-Meter-Daten.
Vollständigkeit und Korrektheit der Daten ohne Ausreißer-Bias.
QUALITY LXP · SCHRITTLOGIK
Modellimplementierung
Bereinigter Normaldatensatz.
Training von Algorithmen, um Korrelationen des Normalzustands zu erlernen.
Trainiertes Modell (z.B. Autoencoder oder Isolation Forest).
Einsatz eines Autoencoders zur Rekonstruktion normaler Betriebsmuster.
Minimierung des Rekonstruktionsfehlers innerhalb der Testdaten.
QUALITY LXP · SCHRITTLOGIK
Kontinuierliches Monitoring
Echtzeit-Datenstrom und Modell.
Vergleich aktueller Live-Messwerte mit dem Modell-Output.
Anomalie-Score oder Warnsignal.
Abgleich von Lagertemperatur gegen Windlast.
Niedrige Latenz und Konsistenz bei der Signalverarbeitung.
QUALITY LXP · SCHRITTLOGIK
Eskalation und Analyse
Warnmeldung mit Kontextdaten.
Fachliche Prüfung der Warnmeldung durch Experten vor Ort.
Diagnosebericht und eingeleitete Maßnahmen.
Manuelle Inspektion eines Lagers.
Rate an falsch-positiven Alarmen.
Anwendung und Vorgehen
Die praktische Anwendung der Anomalieerkennung folgt einem zyklischen Prozess, der weit über die bloße Implementierung eines Algorithmus hinausgeht. Zunächst steht die Definition des Normalzustands, welche das Fundament bildet. Hierbei werden historische Datensätze identifiziert, die einen qualitativ hochwertigen und störungsfreien Betrieb widerspiegeln – etwa die Daten einer Windkraftanlage über 5.000 Betriebsstunden.
Der zweite Schritt, die Datenvorbereitung, ist in der Praxis oft der zeitintensivste. Rohdaten aus industriellen Umgebungen sind selten direkt für KI-Modelle geeignet. Sie müssen von Rauschen befreit, auf eine einheitliche Skala normalisiert und mittels Dimensionsreduktion (z.B. PCA) auf die für den Prozess relevanten Merkmale fokussiert werden. Dies verhindert, dass das Modell "irrelevante" Schwankungen als Anomalien fehlinterpretiert.
Bei der Modellimplementierung kommen zunehmend unüberwachte Lernverfahren zum Einsatz. Da in der Industrie fehlerfreie Daten (Normalzustand) wesentlich leichter verfügbar sind als annotierte Fehlerdaten, trainieren Experten bevorzugt Modelle wie Autoencoder. Diese lernen, den Normalzustand präzise zu rekonstruieren. Der resultierende "Rekonstruktionsfehler" dient im Betrieb als Indikator: Je höher der Fehler, desto stärker weicht das aktuelle Signal vom Erlernten ab.
Das kontinuierliche Monitoring findet in der Echtzeit-Überwachung statt, in der aktuelle Sensordaten (z. B. Lagertemperatur, Vibrationsmuster) kontinuierlich durch das Modell laufen. Schließlich folgt die Eskalation und Analyse. Eine erkannte Anomalie ist kein automatischer Fehlerstopp, sondern ein "Attention-Signal". Die finale Entscheidung über die Kritikalität obliegt stets dem Experten, der durch die Anomalie-Meldung in die Lage versetzt wird, präventive Wartungsmaßnahmen einzuleiten, bevor ein tatsächlicher Systemausfall eintritt.
Anwendungsgebiete
Die Einsatzmöglichkeiten der Anomalieerkennung sind vielfältig und erstrecken sich über datenintensive Branchen:
- Industrielle Fertigung (Predictive Maintenance): Hier ist die Anomalieerkennung das Herzstück der vorausschauenden Wartung. Sie detektiert subtile Abweichungen in hochfrequenten Sensordaten (z. B. Mikro-Vibrationen an Spindeln), die auf einen drohenden Verschleiß hinweisen. Die Herausforderung liegt hier in der hohen Komplexität bei wechselnden Produktvarianten auf derselben Fertigungslinie.
- Energiewirtschaft: Netzbetreiber nutzen die Methode zur Lastprofilanalyse. Durch den Abgleich von Smart-Meter-Daten mit prognostizierten Verbrauchsmustern werden ungewöhnliche Lastspitzen oder Netzstörungen identifiziert. Dabei müssen externe Faktoren wie Wetterbedingungen (PV-Einspeisung, Heizbedarf) zwingend als Kontextvariable einbezogen werden.
- IT-Sicherheit: Bei der Erkennung von Netzwerk-Intrusionen (Anomalie-basierte IDS) fungiert die KI als Wächter. Sie lernt den typischen Traffic-Fluss eines Unternehmensnetzwerks. Plötzliche Datenabflüsse oder ungewöhnliche Login-Versuche, die vom Normalprofil abweichen, lösen Alarm aus, noch bevor bekannte Signatur-basierte Firewalls reagieren könnten.
- Verkehrswesen: In Smart Cities wird die Anomalieerkennung zur Überwachung von Trajektorien an komplexen Kreuzungen eingesetzt. Durch Videoanalyse oder GPS-Tracking werden gefährliche Verkehrssituationen oder Unfälle erkannt, wobei die größte Hürde in der Verdeckung von Objekten in dichten Szenen liegt.
Typische Fehler und Missverständnisse
In der Praxis existieren verbreitete Mythen, die den Projekterfolg gefährden können:
- Verwechslung von Anomalie und Fehler: Viele Anwender erwarten, dass das System den Fehler benennt. Tatsächlich meldet das Modell jedoch nur eine Abweichung. Die Interpretation (Ist es ein Verschleiß? Ein Messfehler? Ein kurzfristiger Prozess-Peak?) erfordert weiterhin menschliche Expertise.
- Der Glaube an die Autonomie: Die Vorstellung, KI-Modelle benötigten keine menschliche Expertise, ist gefährlich. Ohne das Domänenwissen der Ingenieure können die Ergebnisse nicht validiert werden, was schnell zu einer hohen Frustration durch Fehlalarme führt.
- Daten-Inflation: Das Missverständnis, dass "mehr Daten automatisch bessere Ergebnisse liefern", führt oft zu überladenen Modellen. Tatsächlich ist die Datenqualität und die Relevanz der Merkmale entscheidend. Ein Modell, das mit irrelevantem "Datenmüll" gefüttert wird, verliert massiv an Präzision.
- Die Illusion der 100%-Sicherheit: Anomalieerkennung ist ein probabilistisches Werkzeug, kein deterministisches. Sie kann Fehlerwahrscheinlichkeiten senken, aber niemals eine vollständige Fehlerfreiheit garantieren.
Abgrenzung und Grenzen
Die Anomalieerkennung grenzt sich von der klassischen Fehlerdiagnose dadurch ab, dass sie unbekannte Muster erkennen kann, für die keine expliziten Regeln vorliegen. Während klassische Regelsysteme (If-Then) nur bekannte Fehler detektieren, erkennt die Anomalieerkennung das "Unbekannte Unbekannte".
Dennoch gibt es deutliche Grenzen:
- False Positives: Instabile Prozessbedingungen, wie sie bei Anfahrvorgängen oder Rezepturwechseln vorkommen, führen oft zu Alarmen, die keine echten Fehler darstellen. Dies mindert die Akzeptanz beim Personal.
- Interpretierbarkeit (Black-Box-Problematik): Bei Deep-Learning-Modellen ist oft nicht nachvollziehbar, warum eine Abweichung als anomal eingestuft wurde. Dies erschwert das Vertrauen der Wartungsteams.
- Concept Drift: Die schleichende Veränderung des Normalzustands durch Alterung oder klimatische Einflüsse stellt eine große Herausforderung dar. Das Modell muss adaptiv lernen können, sonst führt ein eigentlich korrekter Drift irgendwann zu einem permanenten Alarmzustand.
Häufige Fragen
Wie unterscheidet sich Anomalieerkennung von klassischer Statistik?+
Die klassische Statistik identifiziert oft punktuelle Ausreißer in einfachen Verteilungen (z.B. 3-Sigma-Regel). Moderne Anomalieerkennung mittels Machine Learning betrachtet hochdimensionale Zusammenhänge und zeitliche Korrelationen, die über einfache statistische Kennzahlen nicht mehr erfassbar sind.
Warum treten bei meinen Modellen so viele Fehlalarme auf?+
Häufig liegt dies an einer zu engen Definition des Normalzustands oder einer unzureichenden Bereinigung von Störgrößen. Wenn externe Einflüsse (z. B. wechselnde Umgebungstemperaturen) nicht als Features in das Modell einfließen, werden diese natürlichen Schwankungen fälschlicherweise als Anomalien gewertet.
Wie viele Daten benötige ich für ein zuverlässiges Modell?+
Es kommt nicht auf die bloße Anzahl der Zeilen an, sondern auf die Abdeckung des "Normalraums". Ein kurzes Zeitfenster mit hoher Datenqualität ist wertvoller als Jahre an unstrukturierten Rohdaten. Ein Modell benötigt eine Repräsentation aller relevanten Betriebszustände, um korrekt zu funktionieren.
Kann Anomalieerkennung auch ohne Label-Daten funktionieren?+
Ja, das ist sogar ein Hauptvorteil. Die meisten modernen industriellen Ansätze basieren auf unüberwachtem Lernen, bei dem das Modell nur auf "normalen" Daten trainiert wird. Dies eliminiert die Notwendigkeit, Tausende von historischen Fehlern manuell zu annotieren.
Was mache ich, wenn das System eine Anomalie gemeldet hat?+
Das Signal ist ein Hinweis auf eine notwendige Diagnose. Der nächste Schritt ist eine fachliche Prüfung: Ist die Abweichung plausibel? Gibt es externe Erklärungen? Die Einbindung der Experten vor Ort ist essenziell, um die Anomalie zu bestätigen und zu klassifizieren, was wiederum als Feedbackschleife zur Verbesserung des Modells dienen kann.
Quellen und fachliche Grundlagen
Alle Verknüpfungen sind sichtbar. Zum Öffnen der Starter-Inhalte bitte einloggen.
EinloggenPassende Tools & Methodenwissen
7Projektbeispiele zu diesen Methoden
6GAP – Anforderungs-GAP – Kundenregelwerk A
Norm-/Anforderungsmodus mit Klauselbezug und Evidenzkette.
QMS-Onboarding Lieferanten
Freie GAP-Analyse mit Nachweisen, Maßnahmen und Wirksamkeitsprüfung.
Weitere Tools & Wissen im Themengebiet
Diese Kategorien ergänzen die konkreten Methodentreffer mit weiteren Werkzeugen, Anwendungswissen und Praxisbeispielen.